
AI 读文献的准确性不是一个”准”或”不准”能回答的问题。 格式转换、按规范排版参考文献、整理文献格式——这些环节 AI 做得比人快且很少出错;但文献是否真实存在这一环,AI 会编。
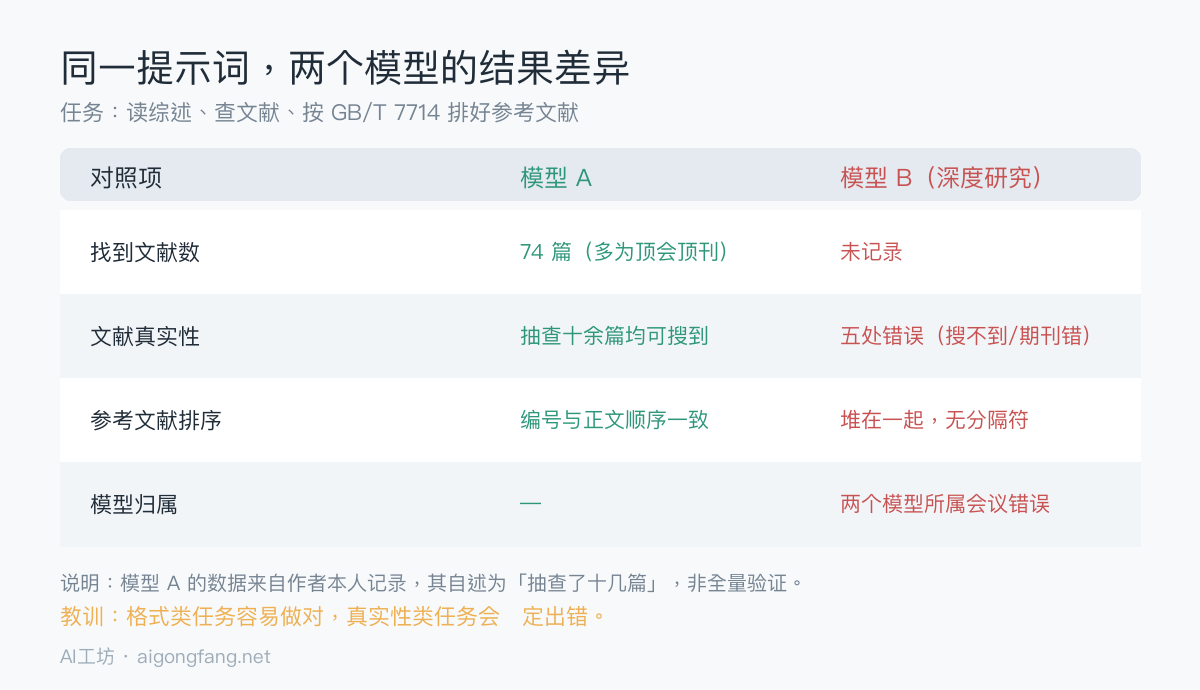
真实案例:有用户让 AI 找国内文献,AI 编了一个叫”张三李四”的作者名。另一位用户做的同题双模型对照里,一个模型找到的 74 篇文献抽查十几篇都对得上,另一个模型的参考文献有五处错误(要么搜不到,要么期刊归属写错)。
所以正确用法不是”能不能用 AI 读文献”,而是把流程拆开,把该核的环节交回给人。
一、先看一组真实对照:同样任务,两个结果
linux.do 用户 `MrChen-hero` 在 2025 年 12 月做了一次同题对照,任务是改开题报告。他给两个模型相同的提示词,要求三件事:
1. 读综述第一部分
2. 查询相关文献,在正文合适位置引用
3. 保证文献编号顺序与正文出现顺序一致,并按 GB/T 7714 格式在参考文献部分列出
Claude 的结果:
- 找到 74 篇文献,大部分是顶会顶刊
- 文献信息真实——但作者如实标注了验证范围:”这里我没有挨个验证,抽查了十几篇都搜到了“
Gemini 深度研究模式(同 prompt)的结果,出现三类问题:
| 问题类型 | 具体表现 |
|---|---|
| 格式 | 参考文献完全没按序号排好,”直接是堆在一起的,每个文献连分隔符都没有” |
| 归属 | 汇总表中两个模型的所属会议错误 |
| 真实性 | 文献中有五处错误——要么搜不到,要么所属期刊错误 |
这个对照的价值不在于”哪个模型更强”,而在于它暴露了一个规律:格式类任务 AI 很容易做对,真实性类任务它会稳定出错。
二、哪些环节可以放心交给 AI
综合多位用户的实操反馈,以下环节可靠性较高:
1. 格式转换
把 PDF 转成 Markdown,`MrChen-hero` 的评价是”效果很好,一字不差,并且公式也和 PDF 上的一样”。
2. 按规范排版参考文献
指定 GB/T 7714 这类格式,让 AI 统一整理——这是纯规则性工作,AI 出错概率低。
3. 按你的课题逻辑找对应辅证
`Silvia`(博三医学生)提到用 NotebookLM:”把课题内容和参考文献上传上去,让它根据我的课题逻辑找出每篇文献中对应辅证的内容并输出,还有整理文献格式都很靠谱。”
4. 提炼后续可用的素材
`Silvia` 用 Claude 写 result 时,它会”顺便提炼出后面 discussion 可用的部分”。
这四个环节的共同点是:AI 处理的是你给它的材料,不需要它去”回忆”或”检索”外部事实。
三、哪些环节必须自己核
核心风险只有一个:文献真实性。
具体表现有三种:
| 表现 | 真实案例来源 |
|---|---|
| 编造作者名 | `ccllyy`:AI”给我编了一个张三李四的作者名字” |
| 期刊/会议归属错误 | `MrChen-hero` 对照中”两个模型所属会议错误“ |
| 文献根本搜不到 | 同上,”五处错误(要么是搜不到…)” |
`ccllyy` 还给出了一条重要的经验边界:“如果是用来找国内的会很离谱……国外的可能都行?”——注意他用的是问号,这是他的观察而非结论,但值得注意:中文文献的 AI 幻觉风险可能更高。
另外 `Silvia` 的观察是 Gemini”幻觉很严重,经常把日期弄错还会编造”,而她认为 Claude”幻觉很低”。这同样是个人使用感受,不是评测结论——换个人、换个任务,结果可能不同。
四、多位用户的一致结论:必须人工核查
这是最值得注意的一点——不同模型偏好的人,在”必须核查”上没有分歧:
- `allyes`:”一定要详细核查啊!!“
- `Learner_ghz`:”推荐使用 gpt,gemini 经常瞎编。最主要是的还需要自己再验证下“
- `zhong_little`:”可以,gpt 和 gemini 的深度研究都还挺准的,但是要保留文献核准以及全面性,不要觉得用 ai 就万事大吉了“
- `MrChen-hero`:建议”让 cc 再次逐条检查参考文献是否真实,如果文献太多可以一次性让它检查十个”
注意最后一条——让 AI 再查一遍,可行性是有限的:文献多了要分批(他建议一次查十个),而且 AI 自查仍是 AI 判断。真正可靠的核验是去数据库里搜那一篇。
五、一套可照做的核验流程
把上面的经验整理成流程:
第 1 步:让 AI 做格式和整理,不做检索
明确告诉它:只处理我给你的材料,不要补充我没提供的文献。
第 2 步:拿到文献列表后,先查真实性
对每一篇,至少核对三项:作者名、期刊/会议名、年份。这三项恰好是出错最集中的地方。
第 3 步:分批核查,别一次丢太多
如果列表很长,按 10 篇一组让它列出来,你逐组去数据库确认——比一次性要它”全部核对”可靠。
第 4 步:国内文献提高警惕
按 `ccllyy` 的观察,中文文献出错概率可能更高,抽查比例要更大。
第 5 步:把”AI 说它对”和”你确认它对”分开记录
`MrChen-hero` 那 74 篇里他自己也只抽查了十几篇。抽查不等于全验——如果这篇文献要写进正式论文,就该逐篇确认,而不是”AI 说搜到了”。
六、一个更根本的用法转变
`Silvia` 在帖子里写了一句很值得琢磨的话:
> “我自己现在的最大收获,提高效率是其次,在和 ai 的沟通中把自己课题的每一个小点都理解透彻才是最大的收获。”
她的用法不是”让 AI 读完告诉我结论”,而是借 AI 把概念问透——她原本是在 CSDN 和公众号里找经验帖,很多概念一知半解,有了 AI 之后”很多问题在课题背景下针对性一问马上就懂了”。
这个转变很关键:把 AI 当”讲解者”而不是”代读者”。 前者不需要它掌握事实(事实在你手上),后者的全部风险都压在它的准确性上。
常见问题
AI 找的参考文献是假的吗?
可能是。真实案例包括编造作者名(”张三李四”)、期刊会议归属错误、文献根本搜不到。必须逐篇核对作者、期刊、年份。
哪个 AI 读文献最准?
没有可靠答案。现有材料都是个人使用感受(`Silvia` 认为 Claude 幻觉低、Gemini 幻觉重;`ccllyy` 推荐 GPT 而非 Claude),样本小、任务不同,不构成评测结论。但所有人在”必须人工核查”上是一致的。
AI 读文献有什么是能放心用的?
PDF 转 Markdown、按 GB/T 7714 排版参考文献、整理文献格式、按你的课题逻辑找对应辅证、提炼后续可用素材。这些处理的是你提供的材料,不依赖 AI 检索外部事实。
可以让 AI 自己核查文献真假吗?
可以作为一种初筛,但要分批(一次约十篇),且不能替代你自己去数据库确认——AI 自查仍是 AI 判断。
用 AI 读文献会被判定学术不端吗?
这取决于你所在学校/期刊的规定。本文只讨论”准确性”这一个技术问题。相关平台规则,可参考AI 写小红书文案会违规吗中梳理的”标识与合规边界”思路——核心是如实说明 AI 参与程度。
延伸阅读:如果你还想把 AI 用在资料整理上,可以看AI 整理用户访谈记录——同样是”AI 处理你给的材料”而非让它检索;或者把聊天记录整理成待办清单。需要把图片里的数据变成可核对的表格,AI 做表格的完整流程里有可直接照做的步骤。想把 AI 输出的表达改得更自然,参考 AI 文字润色提示词。