直接”翻译这份 PDF”,结果通常不能读
如果你试过把一篇英文 PDF 丢给 AI 说”翻译成中文”,大概见过这几种结果:公式变成乱码、表格串行、术语前后不一致、段落被切断导致句子接不上。
这不是模型不行,是流程错了。PDF 是排版格式,不是文本格式——它记的是”这个字画在坐标 (x,y)”,而不是”这句话属于哪一段”。你让模型直接处理 PDF,等于让它去猜版面结构,猜错是常态。
linux.do 上有一篇讲文献翻译的帖子(EzioSweet,2026-03-24,30 赞),楼主把这个问题说得很清楚:
“直接对译为中文 PDF 在很多时候是不合适的,主要问题在于中英文表述相同意义下的字数不同,以及对公式处理不佳。考虑这一点,找到一个合适的中间格式来转可能更好。”
他选的中间格式是 Markdown。理由也实在:纯文本、结构清晰、公式和表格能保留,转完之后还能用 mdbook 这类工具生成网页,多端都能看。
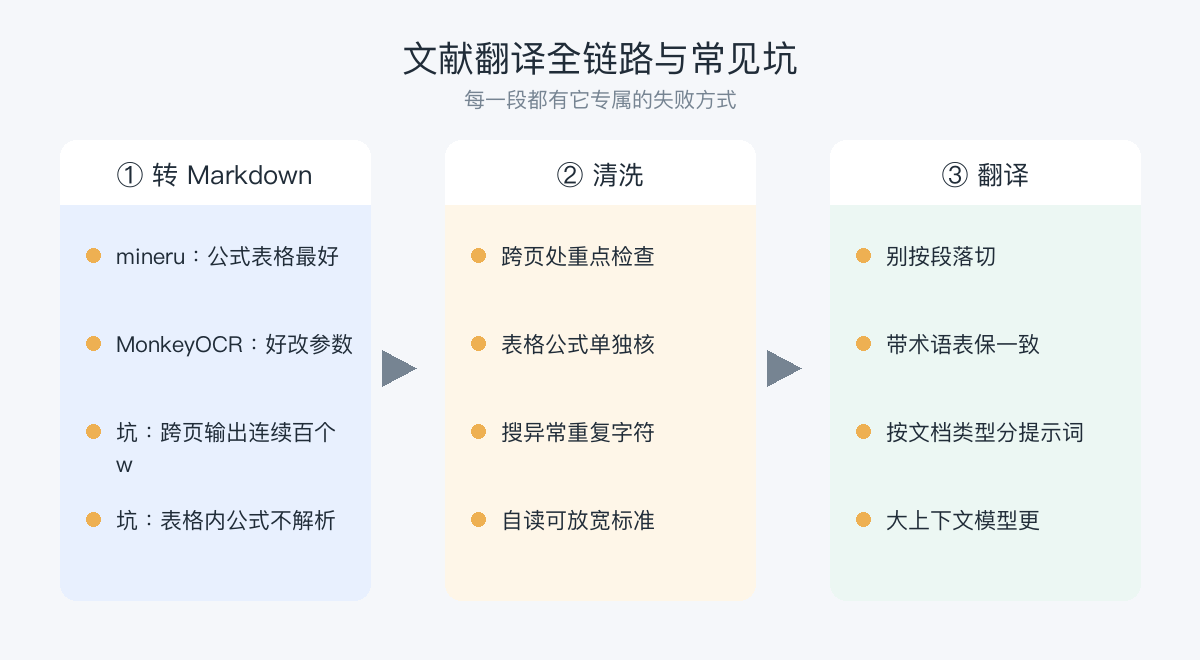
所以正确的流程是三段:PDF 转 Markdown → 清洗 → 翻译。下面逐段说,重点是每一段会踩什么坑。
第一步:PDF 转 Markdown,用哪个工具
这是整条流程里最影响成败的一步。转得不好,后面全白搭。
同帖里 scrapy 给了四条结论,第一条就很明确:
“PDF 转 md 文档首选必须是 mineru,试过市面上免费的和付费的(国外的没试过)工具都没有这个转换出来的效果好。无论是数学公式还是表格方面,都很不错。”
不过楼主自己的选择不太一样,他用的是 MonkeyOCR:
“我试了好几个,最后选择的是 MonkeyOCR,相较于 Deepseek OCR、PaddleVL OCR 等几个模型,这个主要的好处是不费劲,速度和效果……”
两个人都提到 mineru 质量高,但楼主补充了一个关键差异——如果你需要自己改版面识别参数,mineru 的工作流比较难改:
“mineru 2.5 的质量非常之高……mineru 的工作流设计在开源方案里是比较好的一档,但是自己部署 OCR 模型的话,mineru 的工作流相较于 MonkeyOCR 和 DeepseekOCR 的工作流有点难改。我平时读的文献有一部分是需要自己改一下 layout 识别模型的参数的,比较简单的工作流好改一点。”
这段经验很值钱,它说明选工具要看你的用法:
| 你的情况 | 建议 | 理由 |
|---|---|---|
| 只是读文献,不需要调参数 | mineru | 公式和表格的转换效果是公认最好的一档 |
| 版面特殊,需要改识别参数 | MonkeyOCR | 工作流简单,改起来方便 |
| 不想折腾、要省事 | PDF2zh | 同帖有用户反馈”挺好用的”,适合直接出结果 |
第二步:清洗,这一步没有捷径
转换工具不是万能的,转出来的 Markdown 一定有问题。scrapy 的第二条结论就是:”转换 md 文档之后还需要清洗文档,比如某些公式、表格还是有问题。”
楼主补充了两种具体的故障形态,很有代表性:
“很多 OCR 模型总会搞一点有自己特点的输出,尤其是跨页代码的情况下,比如 MonkeyOCR 3B Pro 有时候会输出连续百个 w,Mineru 有时会不解析表格中的公式。”
这两个例子说明清洗要有针对性:
- 跨页的地方重点看。内容被分页切开时,最容易出重复字符或丢失。
- 表格里的公式要单独核。表格结构复杂,公式容易漏解析,变成一个空单元格或乱码。
- 搜一遍异常重复字符。像连续上百个
w这种,用查找替换很快能清掉。
如果只是自己读文献,清洗不用追求完美——楼主说得很实在:”主要目的是能读懂文献而不是做翻译。”公式错了但能看懂上下文,就先往下走。
第三步:翻译,别按段落切
这是最容易做错、也最影响可读性的一步。scrapy 的第三条结论:
“翻译文本的时候不能单纯按段落分割,最好是使用 DeepSeek 和 gemini 这种上下文大的,一定要结合上下文翻译,不然中英文互译涉及专业术语会有问题。”
为什么会出问题?因为一个术语在不同段落里可能是同一个概念的不同侧面。你一段一段独立翻译,模型看不到前文怎么译的,就会换词——读到后面你会以为在讲另一个东西。
楼主也提到全篇塞进上下文有成本问题,他给的替代方案是术语表:
“直接喂整体上下文在有些情况下有点贵,同时考虑到国内用国外模型很多都带着一些上下文产生污染,可以走一些别的路子,比如利用 GalTransl 这样工具提取一个术语表带在上下文里。”
这个思路可以简化成两步操作:
先抽术语表。把文档里的专业名词整理成”英文 → 中文”对照,翻的时候一起给模型。不一定要用工具,人工扫一遍把反复出现的术语挑出来就行。
再分批翻译,但每批都带上术语表。这样既控制了上下文长度,又保证了译名统一。
另外 scrapy 还强调了一点:提示词要按文档类型分开写。“翻译的提示词要反复优化,不同类型的 PDF 文档来区分,这样翻译效果会更好,专业性更强。”论文、合同、说明书的语言习惯差别很大,用同一套提示词,效果会打折。
一份可直接用的文献翻译提示词
把上面几条合起来,可以写成这样:
你是学术文献翻译助手。把下面这段英文 Markdown 翻译成中文。

【术语表】(必须严格使用以下译名,不得替换)
- attention mechanism → 注意力机制
- fine-tuning → 微调
- ablation study → 消融实验
(此处替换为你自己整理的术语表)

【翻译要求】
1. 保持 Markdown 格式不变,标题层级、列表、公式、表格一律原样保留
2. 公式不要翻译,也不要解释,原样输出
3. 术语严格按上面的对照表
4. 学术表达要准确,但避免生硬直译;读起来像中文文献,不要像翻译腔
5. 遇到原文表述含糊的地方,按字面翻译,不要自行补充解释
6. 不确定的专业词,保留英文原文并用括号标注

【输出】
- 只输出翻译后的 Markdown,不要加任何说明
- 如果发现原文有疑似 OCR 错误(乱码、重复字符),在这一处用  标注,但不要擅自修改
第 6 条最后那句”不要擅自修改”是刻意的。模型看到乱码会忍不住”帮你修好”,但一改你就不知道原文是什么了,核对时无从下手。让它标注、不改动,比让它自作主张安全。
核对:这三处必须自己看
翻译完不等于能用。以下三处建议人工过一遍:
- 数字和单位。百分比、样本量、年份、剂量——这些是硬信息,错了后果最严重,而且模型翻译时不会特别标注。
- 公式和符号。重点看有没有在翻译过程中被改动,或者上下标丢失。
- 结论性句子。“显著提升””无统计学差异”这类判断,正反说反了整段意思就错了。模型偶尔会翻反,务必对照原文看一眼。
顺带说一句,这套流程和”AI 读文献”是两件不同的事。翻译解决的是”看不懂英文”,理解解决的是”读懂内容并判断可信度”。后者的坑更多——AI 在文献引用、作者、数据归属上会出错,站内《AI读文献准确吗》专门梳理过哪些环节必须自己核,建议配合这篇一起看。
如果只是想把已转成 Markdown 的长文档提炼要点,站内《AI怎么总结PDF文件》给了提炼要点用的提示词。翻译提示词的通用写法参考《AI翻译提示词怎么写》,那篇讲了术语表和双语对照的格式。工具层面如果要比较具体选择,《AI翻译工具哪个好》按论文、邮件、合同、字幕分了场景。
整体判断
这条流程里,转 Markdown 的质量决定上限,术语表决定一致性,人工核对决定能不能用。三个环节缺一个,出来的东西都会让你在某个地方卡住。
但如果你只是偶尔读一两篇文献,不必上全套。找个工具转成 Markdown 直接读,看不懂的段落单独问 AI,比搭流程快得多。这套流程值得跑的场合是:你要读的量很大,或者同一个领域的文献要持续读下去——那时候术语表会越攒越有用。