
会。但风险不在于”用了 AI”,而在于”会议内容走了哪条链路”。
同样是用 AI 整理会议记录,把录音丢进本地部署的模型,和粘贴到某个免费网页版、或经过第三方 API 中转站,暴露面完全不同。真正需要判断的不是”能不能用 AI”,而是这份会议内容属于哪一档,该走哪条路。
2026 年”用 AI 整理会议记录导致泄密”曾登上热搜,央视新闻报道了此事。同期多个省级保密部门、检察院、地方政府密集发布提示,提醒办公场景的 AI 使用风险。这不是危言耸听——是已经发生的事。
一、先分清:三类会议内容,三条链路
把所有会议一刀切禁止用 AI,既不现实也没必要。更可操作的做法是按内容分级:
| 内容类型 | 判断标准 | 建议链路 |
|---|---|---|
| 涉密 / 敏感 | 涉及未公开的经营数据、人事决定、法务纠纷、客户隐私 | 不上传任何云端服务;必要时用本地部署模型 |
| 内部一般 | 部门排期、流程讨论、公开前的普通项目信息 | 可用企业版/API 版,不用个人免费版 |
| 公开 / 已发布 | 已对外公开的内容、通用方法论 | 链路限制较松 |
这张表的关键在中间一行:“内部一般”是最容易被误判的一档。很多人觉得”这也不算机密吧”,就随手粘进了免费网页版——而免费版恰恰是数据条款最宽的一档。
二、为什么”免费版”风险最高
这不是猜测,是条款写明的。
linux.do 用户 `Uiharu_Kazari` 在分析 Google AI Studio 时写道:
> “对于绝大多数免费用户,Google 的服务条款里写得很清楚,你的数据会被用来改进产品,甚至可能有人工审核。”
也就是说,同一家公司的同一个产品,不同档位的隐私条款并不一样。付费版、企业版、API 版往往有豁免;免费版通常是数据使用最宽的一档。
一个具体的对照:据公开报道,Anthropic 在 2025 年的消费者条款更新中,把选择将数据用于训练的用户的数据保留期从 30 天延长到 5 年;未选择加入训练的,仍适用 30 天保留期。而 Claude Gov、Claude for Work、Claude for Education,以及通过 API 接入的商业客户不受该变更影响。
这个例子说明两件事:
1. 企业版/API 版和消费级版本的条款是分开的——用哪个入口,决定了数据怎么被处理
2. 数据保留期是会变的——你半年前查过的条款,现在可能已经不同了
三、最容易被忽略的盲区:第三方中转站
除了官方渠道,还有一种常见做法是自己搭或用第三方 API 中转站。这一环的透明度往往更低。
linux.do 用户 `Clancy` 分享过一个细节:某中转服务的实物卡片反面印着两行字——
> “(已启用数据共享,禁止发送涉密信息!)”
连服务提供方自己都要标注”禁止发送涉密信息”,说明数据在中转环节的流向是不透明的。你用起来和官方 API 没有区别,但数据经过了谁、留了什么,你并不清楚。
企业环境里判断这一环,可以直接问三个问题:
- 这个中转服务由谁运营?
- 请求会不会被记录?
- 出问题谁负责?
三个都答不上来,就不该走涉密或内部内容。
四、一个可参考的实践:把”涉密模式”做成开关
有人已经把这件事做成了产品设计。linux.do 用户 `mini_h` 开源的会议记录系统 Meeting Mind,卖点第一条就是”确保数据隐私和安全”,它的核心设计是:
> “涉密模式切换:支持本地处理(涉密)与云端高精度转写(非涉密)两种模式。”
这个思路值得直接借用——不是禁用 AI,而是按内容级别切换链路:
- 涉密会议 → 走本地模型(功能弱一点,但数据不出机器)
- 非涉密会议 → 走云端(精度更高、更省事)
同一套工作流,两种模式,由你按会议性质选择。这比”要么全用要么全禁”实际得多。
五、还有两个容易漏的点
1. 账号是谁给的,影响数据归属
linux.do 用户 `techtech` 研究 OpenAI 教育条款时发现:挂靠学校申请的账号,”你的内容可能会与学校共享,并可能被学校修改、删除或访问“。
也就是说,用个人账号、公司账号还是学校账号,数据归属和可见范围不同。在单位里用自己注册的免费账号处理公司会议记录,这个组合本身就有问题。
2. 删掉对话不等于没留存
前面提到的条款变更里有一句关键:选择加入训练的用户,删除与 AI 的对话后,该对话不会再用于未来的模型训练——但这句话反过来读是:删除只影响”未来”,已经用于训练的无法撤回。
所以”事后删掉”不是安全措施。判断要在粘贴之前做,不是在粘贴之后。
六、一份可照做的自查清单
开会前花一分钟过一遍:
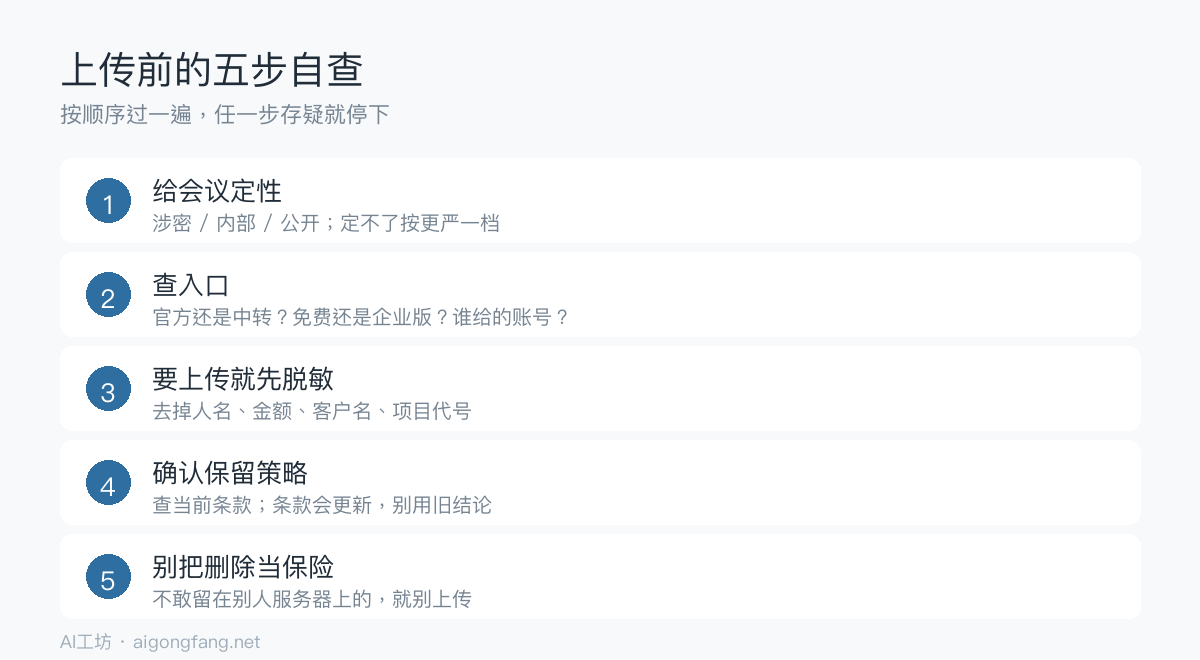
第一步:给这场会定性
是涉密/敏感、内部一般,还是公开内容?定不了性的,按更严的一档处理。
第二步:检查你要用的入口
- 是官方产品还是第三方中转?
- 是免费版还是企业版/API 版?
- 账号是你自己的,还是单位/学校分配的?
第三步:需要上传录音或文字时
涉密内容只在本地模型处理;确需云端时,先做脱敏——去掉人名、金额、客户名、未公开的项目代号。
第四步:确认保留策略
查一次当前条款的数据保留期与训练用途。注意条款会更新,别沿用旧结论。
第五步:不把”事后删除”当保险
如果一份内容你不敢让它留在别人的服务器上,那就不要上传。
常见问题
用 AI 整理会议记录一定泄密吗?
不一定。风险取决于内容级别和所用链路。用本地部署模型处理涉密内容,数据不出机器;把涉密内容粘贴到免费网页版,风险就很高。
公司允许用 AI,是不是就没问题了?
不是。”允许用 AI”通常不等于”允许用任何 AI 处理任何内容”。公司政策往往还会限定可用工具、账号类型和内容范围,需要单独确认。
删掉对话记录就安全了吗?
不能这样理解。删除影响的是未来是否继续用于训练,已经发生的数据处理无法撤回。
企业版/API 版是不是就没有风险?
风险更低,但不是零。至少还要确认服务方的数据保留政策与你所在单位的规定是否一致。
只有我一个人用,随便传点内容有关系吗?
有关系。泄露的判定看的是内容本身是否敏感,不看传的人有几个。会议记录里往往包含他人信息,还涉及第三方权益。
延伸阅读:如果确认用法合规,可以看DeepSeek 怎么写会议纪要了解从录音文字到结论、待办的具体写法,或直接用会议纪要生成工具。处理内部资料时,整理用户访谈记录同样要注意脱敏。把会议结论转成可跟进的清单,参考从聊天记录整理待办。想让 AI 输出的表达更自然,参考 AI 文字润色提示词。